
AI视觉词典 / 开放接口
让 AI 先看懂风格,
再写出提示词。
把同一本视觉词典交给你的 AI。根据场景找术语,查看参考效果,挑选相容的表达,组合成图片或视频提示词。
配置 AI 连接 也可以自己看图挑选 →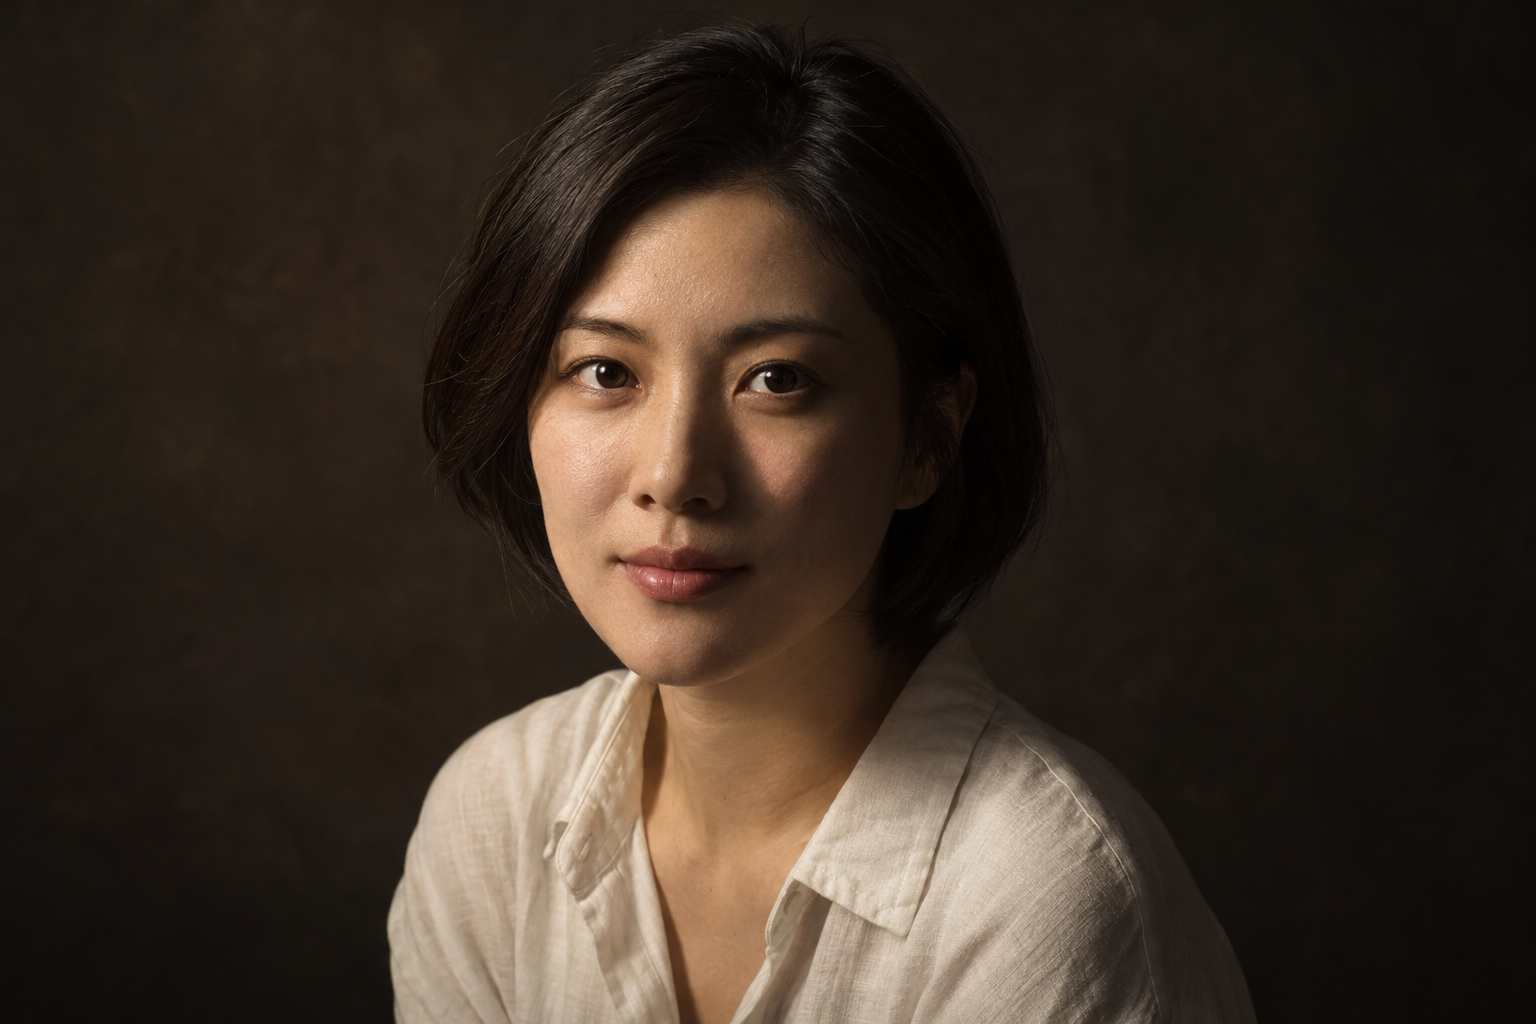 AI 生成参考 · 布光示例
伦勃朗光
Rembrandt lighting
看暗侧眼下的亮三角,比堆叠“电影感”更具体。
描述你要的场景
例如“雨夜街头,孤独感,缓慢推进”。
检索并查看参考
阅读特征与适用范围,实际看候选图片。
组合少量相容术语
检查冲突,保留你的主体、情绪和约束。
交给生成工具使用
输出提示词;视频剪辑要求会单独列出。
CONNECT / 接入方式
选一个适合你的入口。
网页可直接浏览。AI 接口使用独立访问令牌,请向站点管理员获取。
连接到同一本词典
选择 Streamable HTTP,填写下面的 URL,并设置 Authorization 请求头。需要客户端支持自定义 Bearer 鉴权;只支持 OAuth 的连接器暂不能直接接入。
- 连接地址
https://look.qipaoai.com/mcp- 鉴权请求头
Authorization: Bearer YOUR_TOKEN
[mcp_servers.shici]
url = "https://look.qipaoai.com/mcp"
bearer_token_env_var = "SHICI_API_TOKEN"
在运行客户端的电脑上,将令牌设为环境变量 SHICI_API_TOKEN,再重启客户端。如果已存在 shici 配置,请编辑原配置,避免重复添加。
让你的程序直接检索
所有数据与网页、MCP 一致。查询和组合使用 JSON,参考接口返回 JPEG 图片。每次请求都带上 Bearer 令牌。
- 接口根地址
https://look.qipaoai.com/api- 请求体上限
- 64 KiB · 搜索每页最多 30 条
curl https://look.qipaoai.com/api/search \
  -H "Authorization: Bearer $SHICI_API_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{"query":"雨夜街头 孤独 缓慢推进","media":"video","limit":6}'
命令适用于 Bash。令牌由环境变量读取,不需要写进源码。
连好之后,试着这样说
请使用 AI视觉词典,为“成年女主在雨夜街头独自走过,克制而孤独”的视频检索合适的光影、色彩和运镜。先阅读条目并查看参考图,再选择少量相容术语,输出中文提示词,保留我的场景,不要堆叠互相冲突的效果。
REFERENCE / 能力一览
从检索,到可用的表达。
两种接口使用同一套数据和组合规则。
| 要做什么 | MCP 工具 | HTTP API |
|---|---|---|
| 了解分类与收录范围 | list_catalog | GET /api/catalog |
| 按场景查找候选术语 | search_visuals | POST /api/search |
| 读特征、来源与适用范围 | get_visuals | POST /api/entries |
| 实际查看参考效果 | view_reference | GET /api/reference?id=… |
| 组合提示词与检查冲突 | compose_prompt | POST /api/compose |
查看 HTTP 参数与调用顺序
先搜索,再将返回的真实 ID 传给详情、参考和组合接口。ID 分为 term:、look:、memory: 三类。不要自行猜测 ID。
POST /api/entries
{"ids":["term:rembrandt"]}

GET /api/reference?id=term%3Arembrandt

POST /api/compose
{"scene":"成年女主站在窗前","ids":["term:rembrandt"],"media":"image","language":"zh"}
搜索支持 media: image | video | all、kind: term | look | memory | all、category、limit、offset、excludeIds。组合需明确指定 media: image | video,可选 language: zh | en 和补充约束 extra。详情每次最多 12 个 ID,组合最多 24 个;使用少量相容项通常更清晰。
参考效果,不是效果承诺
词典帮助你表达画面,不直接生成图片或视频。检索按术语、别名和场景线索匹配;生成结果仍取决于模型、主体和提示词组合。示例标注各自来源与限制。
遇到连接问题?
401:检查 Bearer 令牌。403:检查连接地址及 Origin。429:降低请求频率后重试。地址可以用浏览器打开,不代表 MCP 客户端已完成连接;请实际调用检索和参考工具验证。